
DeepSeek öffnet sein Inferenz-Framework DeepInfer
22. Oktober 2026
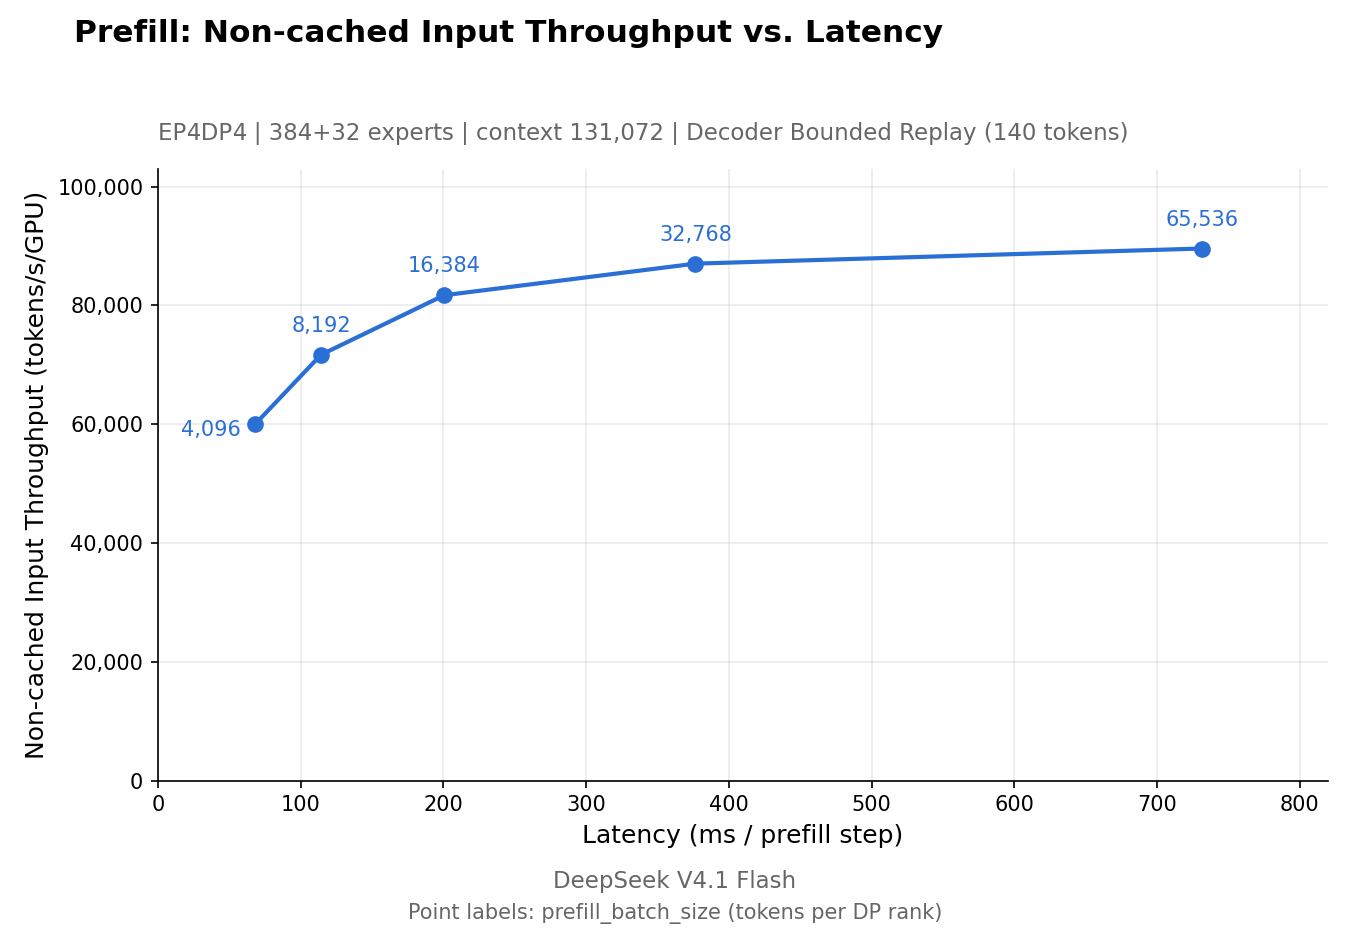
DeepSeek stellt mit DeepInfer zentrale Teile seines Produktionssystems unter Apache 2.0 bereit. Die Veröffentlichung ist leistungsfähig, aber noch kein vollständiger KI-Dienst.
Worum es geht
DeepSeek hat am 20. Oktober 2026 sein Inferenz-Framework DeepInfer als Open-Source-Software veröffentlicht. Inferenz bezeichnet die Phase, in der ein bereits trainiertes Modell Anfragen verarbeitet und Antworten erzeugt. Gerade bei großen Modellen entscheidet diese Schicht darüber, wie viele Anfragen ein Rechenzentrum bedienen kann, wie lange Nutzer warten und wie hoch Energie- und Hardwarekosten ausfallen.
DeepInfer treibt nach Angaben von DeepSeek den Produktionsbetrieb von DeepSeek-V4.1-Flash an. Der Code steht unter der Apache-2.0-Lizenz. Damit erhalten Entwickler Einblick in Optimierungen, die sonst häufig nur hinter kommerziellen Programmierschnittstellen sichtbar werden.
Was DeepInfer tatsächlich macht
Das Framework koordiniert Modellberechnung, parallele Verarbeitung und die Ausgabe von Text auf großen Beschleunigerverbünden. Es enthält optimierte Rechenkerne, asynchrone Planung, Expert Parallelism für Mixture-of-Experts-Modelle, spekulatives Decoding und strukturierte Ausgaben nach regulären Ausdrücken, JSON-Schema oder EBNF-Grammatik.
Spekulatives Decoding lässt das System mehrere mögliche nächste Token vorhersagen und anschließend gesammelt prüfen. Asynchrone Planung überlappt Arbeit auf der CPU mit Berechnungen auf den Beschleunigern, damit teure Hardware seltener untätig bleibt. Eine optionale Einstellung sorgt dafür, dass identische Eingaben auch bei unterschiedlicher Stapelzusammensetzung dasselbe Ergebnis liefern.
Die erste Version unterstützt DeepSeek-V4.1-Flash sowie Nvidia-Grafikprozessoren der SM100-Klasse und Huawei Ascend 950. Für die dokumentierten Messungen nutzte DeepSeek vier SM100-Beschleuniger für die Vorverarbeitung und 64 für die Textausgabe. Das macht klar: Die Veröffentlichung richtet sich an Betreiber großer Systeme, nicht an einen gewöhnlichen Laptop.
Warum das wichtig ist
Die Kosten moderner KI entstehen nicht nur beim Training. Häufige Nutzung verursacht dauerhaft Inferenzkosten, und kleine Effizienzgewinne werden bei Milliarden Token wirtschaftlich relevant. Ein offenes Produktions-Framework ermöglicht Forschungsteams und Cloud-Anbietern, technische Entscheidungen zu prüfen, eigene Messungen anzustellen und Verbesserungen zurück in andere Projekte zu übertragen.
DeepInfer entstand laut Repository vor allem auf Basis von vLLM und nennt außerdem SGLang und TensorRT-LLM als Inspiration. Das vLLM-Team berichtete nach der Veröffentlichung, bei einer vergleichbaren Konfiguration innerhalb von sechs Prozent der von DeepInfer veröffentlichten Decode-Leistung zu liegen. Dieser Vergleich relativiert die Vorstellung, DeepSeeks Leistung sei nur mit einem einzigartigen System erreichbar.
Gleichzeitig schafft die Veröffentlichung mehr Wettbewerb zwischen Nvidia- und Huawei-Hardware. Dass derselbe Code beide Plattformen anspricht, kann Betreibern mehr Wahlmöglichkeiten geben. Es ist jedoch noch offen, wie gut Portierung, Wartung und Leistung außerhalb der von DeepSeek getesteten Konfigurationen ausfallen.
Einfach erklärt
Ein großes Sprachmodell ist wie eine sehr gut ausgestattete Großküche. Das Modell entspricht den Rezepten und dem Können der Köche; das Inferenz-Framework ist die Person, die Bestellungen verteilt, freie Arbeitsflächen nutzt und dafür sorgt, dass kein Ofen leer läuft. DeepInfer veröffentlicht einen großen Teil dieses Organisationssystems, aber nicht das gesamte Restaurant mit Lager, Lieferdienst und Kasse.
Praktisches Beispiel
Ein Betreiber erhält in einer Minute 10.000 Anfragen mit sehr unterschiedlichen Längen. Würde er sie nur nach Eingangszeit gleich behandeln, könnten wenige lange Anfragen viele kurze blockieren. DeepInfer schätzt Rechenaufwand, verteilt Vorverarbeitung und Ausgabe getrennt und kann CPU-Planung mit der Arbeit auf Beschleunigern überlappen.
In einem realen Dienst wären zusätzlich gemeinsam genutzte Zwischenspeicher, Lastverteilung über mehrere Rechenzentren und Ausfallsicherung nötig. Genau diese Teile sind in der ersten Veröffentlichung nicht vollständig enthalten. Das Beispiel erklärt daher den Nutzen des Frameworks, nicht eine garantierte Kostenersparnis.
Einordnung und Grenzen
Erstens ist DeepInfer kein schlüsselfertiger Ersatz für einen Cloud-Dienst. Das Repository nennt ein vollständiges KV-Cache-System, die Trennung von Vorverarbeitung und Ausgabe sowie die Lastverteilung über Replikate ausdrücklich als noch benötigte Komponenten. Zweitens unterstützt die erste Fassung nur ein DeepSeek-Modell und sehr teure Serverhardware.
Drittens stammen die wichtigsten Leistungswerte vom Hersteller und aus einzelnen Reproduktionen. Ergebnisse hängen stark von Anfragemix, Cache-Trefferrate, Stapelgröße und Hardware ab. Angaben wie Token pro Tag dürfen nicht mit neu berechneten Ausgabe-Token gleichgesetzt werden, wenn ein großer Teil aus dem Cache stammt. Teams sollten deshalb reproduzierbare Messungen mit ihrem eigenen Datenverkehr durchführen, bevor sie Kosten- oder Energieversprechen übernehmen.
SEO- und GEO-Schlüsselbegriffe
DeepInfer, DeepSeek, DeepSeek-V4.1-Flash, Inferenz-Framework, Open Source AI, Apache 2.0, vLLM, Nvidia SM100, Huawei Ascend 950, Mixture of Experts, spekulatives Decoding, strukturierte Ausgaben
💡 Im Klartext
DeepInfer ist die Software, die große DeepSeek-Modelle im laufenden Betrieb effizient auf viele Beschleuniger verteilt. Der Code ist offen, aber wichtige Bausteine für einen vollständigen Cloud-Dienst müssen Betreiber selbst ergänzen.
Wichtigste Erkenntnisse
- →DeepInfer steht unter der Apache-2.0-Lizenz.
- →Die erste Version unterstützt DeepSeek-V4.1-Flash auf Nvidia SM100 und Huawei Ascend 950.
- →Das Framework enthält asynchrone Planung, spekulatives Decoding und strukturierte Ausgaben.
- →Ein vollständiges Cache- und Lastverteilungssystem ist nicht Bestandteil der Veröffentlichung.
- →Die veröffentlichten Leistungswerte müssen für konkrete Arbeitslasten unabhängig geprüft werden.
Häufige Fragen
Was ist DeepInfer?
DeepInfer ist ein offenes Framework für die Inferenz großer DeepSeek-Modelle auf vielen Beschleunigern.
Kann DeepInfer auf einem normalen PC laufen?
Die erste dokumentierte Version richtet sich an Nvidia-SM100- oder Huawei-Ascend-950-Systeme und damit an Rechenzentren, nicht an gewöhnliche PCs.
Ist DeepInfer ein vollständiger KI-Dienst?
Nein. Cache-Verwaltung, umfassende Lastverteilung und weitere Betriebsbausteine müssen ergänzt werden.
Welche Lizenz verwendet DeepInfer?
Der Quellcode steht im offiziellen Repository unter Apache 2.0.