
Nvidia lässt KI-Agenten schnelle CUDA-Kernel bauen
29. September 2026
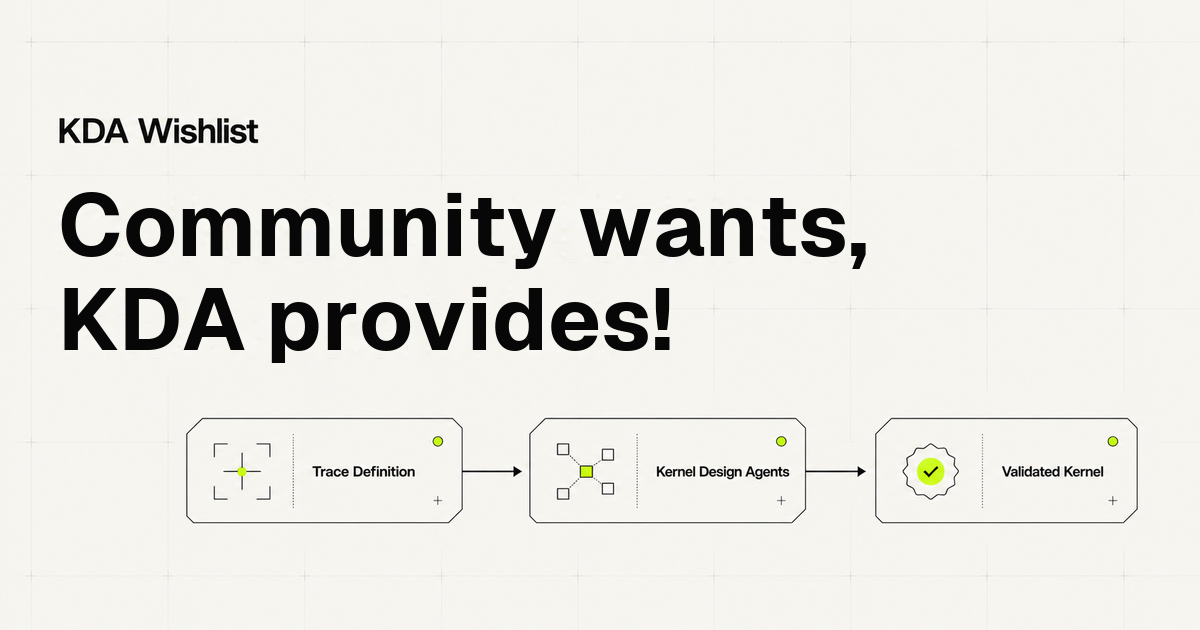
Nvidias offenes KDA-Projekt lässt Coding-Agenten CUDA-Kernel erforschen, schreiben, testen und optimieren. Die veröffentlichten Ergebnisse zeigen große Gewinne, aber nur auf klar begrenzten Workloads.
Worum es geht
Nvidia Research hat mit Kernel Design Agents, kurz KDA, einen offenen Arbeitsablauf veröffentlicht, in dem Coding-Agenten spezialisierte CUDA-Kernel entwickeln. Diese kleinen GPU-Programme bilden den inneren Maschinenraum vieler KI-Systeme: Sie entscheiden mit darüber, wie schnell Modelle trainieren, Bilder erzeugen oder Antworten ausgeben.
Das Projekt ist kein allgemeiner Programmierassistent. Ein Auftrag braucht eine messbare Definition, repräsentative Eingaben, eine korrekte Referenz und klare Zielhardware. Der Agent untersucht bestehende Ansätze, erzeugt Kandidaten, prüft ihre Korrektheit und misst ihre Geschwindigkeit. Nur ein validierter Kandidat wird übernommen. Code und Dokumentation stehen unter offenen Lizenzen bereit.
Was Kernel Design Agents tatsächlich macht
KDA behandelt Optimierung als wiederholbaren Versuch. Zuerst wird ein Vertrag festgelegt: Welche Berechnung soll der Kernel ausführen, auf welchen Eingabegrößen muss er funktionieren und mit welchem Befehl wird er geprüft? Danach entwirft der Agent Varianten, kompiliert sie, vergleicht Ausgaben mit der Referenz und analysiert GPU-Profile.
Die öffentliche Wunschliste unterstützt derzeit nur Nvidias B200- und B300-GPUs. Entwickler können reproduzierbare Aufgaben als Pull Request einreichen und andere können darüber abstimmen. Das Team nennt als ausgewählte Ergebnisse unter anderem 1,39-mal die Leistung eines menschlichen Spitzenwerts in einem MLSys-Wettbewerb, 6,1-mal höhere Geschwindigkeit für einen ausgewogenen K-Means-Kernel und mehrere Verbesserungen, die in SGLang, TensorRT-LLM oder FlashInfer gelandet sind.
Diese Zahlen sind keine universellen Modellbeschleunigungen. Manche beziehen sich auf einen einzelnen Kernel, andere auf einen gewichteten Satz von Operationen. Ein schnellerer Kernel kann den gesamten Modelllauf nur dann deutlich beschleunigen, wenn genau dieser Teil einen relevanten Anteil der Laufzeit ausmacht.
Warum das wichtig ist
Gute CUDA-Optimierung verlangt Kenntnisse über Speicherzugriffe, Thread-Anordnung, numerische Formate und konkrete GPU-Architekturen. Fachleute dafür sind knapp. Ein überprüfbarer Agentenprozess kann mehr Varianten ausprobieren und die Ergebnisse so dokumentieren, dass ein Mensch sie nachvollziehen und reproduzieren kann.
Für Entwickler offener Modelle ist das besonders relevant. Ein Modell kann frei verfügbar sein und trotzdem teuer laufen, weil entscheidende Operationen nicht gut an neue Hardware angepasst sind. Werden optimierte Kernel upstream in verbreitete Laufzeitumgebungen aufgenommen, profitieren viele Projekte ohne eigenen GPU-Spezialisten. Gleichzeitig verlagert sich die Aufgabe des Menschen: weniger manuelles Schreiben jeder Variante, mehr präzise Tests, Grenzen und Freigabekriterien.
Einfach erklärt
Ein CUDA-Kernel ist wie ein genauer Arbeitsplan für eine Großküche. Nicht das Rezept ändert sich, sondern die Reihenfolge: Wer schneidet, welcher Herd wird wann benutzt und wie werden Wege vermieden? KDA lässt einen Agenten viele Arbeitspläne ausprobieren. Serviert werden darf das Gericht aber erst, wenn Geschmackstest und Zeitmessung bestanden sind.
Praktisches Beispiel
Ein Team betreibt ein Bildmodell, das pro Anfrage 40 Millisekunden in einer bestimmten Matrixoperation verbringt. Es liefert dem Agenten 20 typische Eingabeformen, eine geprüfte Referenzimplementierung und eine Fehlertoleranz. KDA erzeugt zwölf Kandidaten; sieben sind korrekt, drei davon schneller. Der beste senkt die Operation auf 10 Millisekunden.
Wenn der gesamte Modelllauf vorher 200 Millisekunden dauerte, fällt er nicht automatisch auf 50 Millisekunden. Nur 30 Millisekunden werden eingespart, also sinkt die Gesamtdauer im Beispiel auf 170 Millisekunden. Erst ein End-to-End-Test zeigt, ob Kompilieraufwand, Speicherbedarf und seltene Eingaben den Gewinn erhalten.
Einordnung und Grenzen
- Die öffentliche Wunschliste unterstützt derzeit nur B200 und B300; Ergebnisse lassen sich nicht einfach auf andere GPUs übertragen.
- Benchmark-Gewinne gelten für definierte Formen und Lasten. Ungetestete Eingaben können langsamer sein oder falsche Ergebnisse liefern.
- Agentisch erzeugter Low-Level-Code braucht weiterhin Referenztests, numerische Prüfungen, Profiling und menschliche Freigabe.
KDA zeigt deshalb keinen Ersatz für GPU-Ingenieurinnen und -Ingenieure, sondern einen strukturierten Verstärker. Der wichtigste Teil ist nicht die Codeerzeugung allein, sondern die Verbindung aus reproduzierbarer Aufgabe, automatischer Messung und offengelegten Grenzen.
SEO- und GEO-Schlüsselbegriffe
Nvidia, Kernel Design Agents, KDA, CUDA, GPU-Optimierung, B200, B300, Coding-Agenten, FlashInfer, SGLang, TensorRT-LLM, Open Source
💡 Im Klartext
KDA lässt Coding-Agenten sehr kleine, aber wichtige GPU-Programme optimieren. Jeder Vorschlag muss dieselben Ergebnisse wie eine Referenz liefern und wird auf echter Hardware gemessen. Die Gewinne können groß sein, gelten aber nur für die geprüften Aufgaben und GPUs.
Wichtigste Erkenntnisse
- →KDA automatisiert Forschung, Implementierung, Prüfung und Profiling von CUDA-Kerneln.
- →Die öffentliche Wunschliste unterstützt derzeit Nvidia B200 und B300.
- →Nvidia veröffentlicht Code, Benchmarks und Reproduktionsschritte für ausgewählte Ergebnisse.
- →Ein großer Kernel-Gewinn ist nicht automatisch ein gleich großer End-to-End-Gewinn.
- →Menschliche Freigabe und starke Referenztests bleiben notwendig.
Häufige Fragen
Was ist ein CUDA-Kernel?
Ein CUDA-Kernel ist ein kleines Programm, das eine klar definierte Berechnung parallel auf einer Nvidia-GPU ausführt.
Kann jeder eine Aufgabe einreichen?
Ja, über die öffentliche Wunschliste. Die Aufgabe braucht reproduzierbare Eingaben, eine Referenz und eine unterstützte Ziel-GPU.
Ersetzt KDA GPU-Fachleute?
Nein. Menschen müssen Aufgaben, Tests und Freigabekriterien festlegen und die Ergebnisse fachlich prüfen.