
VoiceMem gibt Sprachagenten ein streamendes Langzeitgedächtnis
26. September 2026
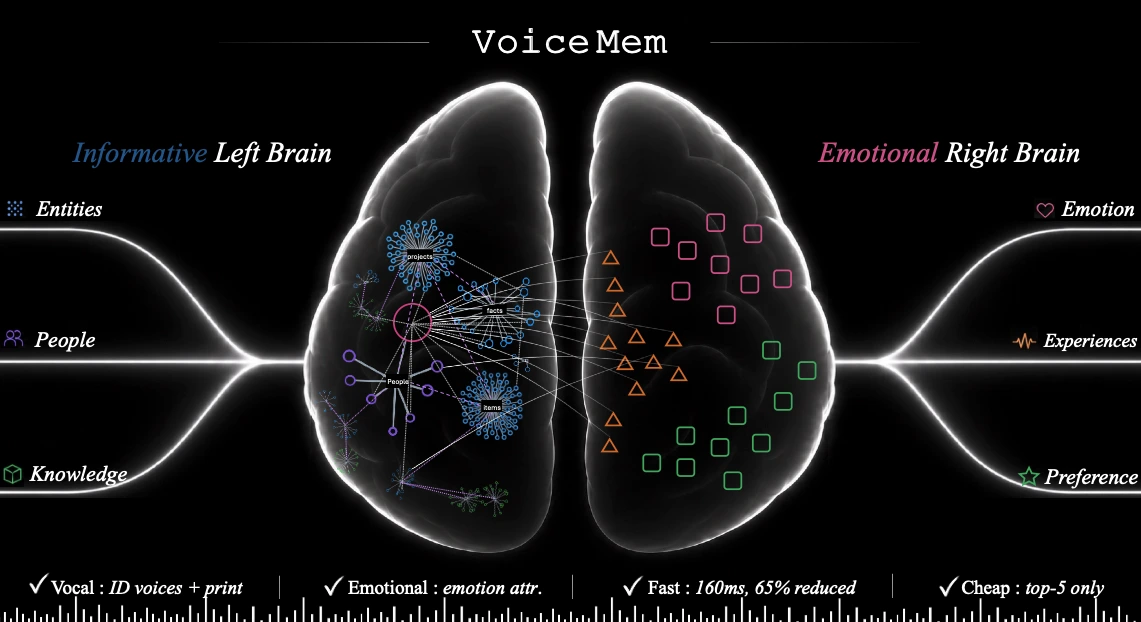
VoiceMem speichert Fakten, Sprechermerkmale und emotionale Zusammenhänge für Sprachagenten. Die offene Bibliothek arbeitet teilweise lokal, benötigt für die Extraktion aber externe Modelle.
Worum es geht
VoiceMem ist eine offene Speicherkomponente für Sprachagenten. Sie verarbeitet laufende Gespräche, trennt Fakten von emotionalen und persönlichen Zusammenhängen und liefert einem Antwortmodell nur die jeweils relevanten Erinnerungen. Das Projekt erschien Ende August 2026; Version 0.0.2 vom 1. September öffnete unter anderem die Sprachsynthese-Schicht für austauschbare Komponenten.
Die Software richtet sich an Entwickler, die einem Sprachassistenten ein dauerhaftes Gedächtnis geben wollen. Sie ist keine fertige Telefon- oder Assistenten-App. VoiceMem wird als Python-Paket eingebunden, bietet eine lokale Webdemo und veröffentlicht Modelle, Hilfsdateien, Trainingsdaten sowie Auswertungscode.
Was VoiceMem tatsächlich macht
VoiceMem teilt Erinnerungen in zwei Bereiche. Das sogenannte linke Gehirn organisiert Fakten über Schemata und Entitäten. Das rechte Gehirn hält Angaben zu Persönlichkeit, Beziehungen und emotionalen Verläufen. Beim Sprechen verarbeitet eine Pipeline Audioabschnitte, Transkription, Sprechermerkmale, Geräusche und Emotionen. Eine vorgezogene Suche kann beginnen, bevor der Nutzer seinen Satz beendet hat.
Bei einer Anfrage werden Erinnerungen zunächst ausgewählt und sortiert. Nur die am höchsten bewerteten Einträge gelangen in den Kontext des Antwortmodells. Der eigentliche Abruf kann lokal laufen. Für das Extrahieren neuer Fakten nutzt die Standardkonfiguration jedoch einen OpenAI-Schlüssel; die Dokumentation beschreibt die Komponenten als austauschbar. Das Paket steht unter Apache 2.0 und lässt sich per pip install voicemem installieren.
Warum das wichtig ist
Sprachagenten verlieren ohne dauerhaften Speicher entweder den Gesprächskontext oder schicken lange Verläufe immer wieder an ein Modell. Beides ist unpraktisch: Vergessen verschlechtert die Erfahrung, während vollständige Protokolle Kosten und Datenschutzrisiken erhöhen. VoiceMem versucht, nur kleine, passende Ausschnitte bereitzustellen und gleichzeitig Fakten von Beziehungen und Stimmung zu trennen.
Das Repository veröffentlicht einen technischen Bericht, den Datensatz ChatMem-400K und reproduzierbaren Auswertungscode. Die dort genannten Werte, darunter Ergebnisse auf LoCoMo und PersonaMem, stammen vom Projektteam und sollten nicht als unabhängiger Produktvergleich gelesen werden. Der praktische Wert liegt zunächst in der überprüfbaren Architektur und der Möglichkeit, Speicher, Modelle und Sprachsynthese auszutauschen.
Einfach erklärt
Stell dir eine Empfangskraft mit zwei Notizbüchern vor. Im ersten stehen nüchterne Fakten wie Allergien oder Termine. Im zweiten stehen Beziehungen und Stimmungen, etwa dass ein bestimmtes Thema belastend war. Vor einem neuen Gespräch schlägt sie nur die drei bis fünf passenden Notizen auf, statt das gesamte Archiv auf den Tisch zu legen.
Praktisches Beispiel
Ein Team baut einen Sprachassistenten für die Terminplanung. Eine Nutzerin erwähnt in Gespräch eins, dass sie dienstags nie verfügbar ist und Anrufe am Vormittag bevorzugt. VoiceMem speichert diese beiden Angaben. Eine Woche später fragt sie nach einem Termin; der Assistent ruft nur die passenden Erinnerungen ab und schlägt Donnerstag um 10 Uhr vor.
Das Team testet 100 synthetische Gesprächsfolgen und prüft getrennt, ob Fakten korrekt gespeichert, später wiedergefunden und bei Widerruf gelöscht werden. Erst danach folgen freiwillige Tests mit echten Personen. Rohaufnahmen werden nicht dauerhaft aufbewahrt, und sensible Kategorien bleiben von der Speicherung ausgeschlossen.
Einordnung und Grenzen
Erstens ist Version 0.0.2 ein junges Projekt. Schnittstellen, Datenformate und Betriebseigenschaften können sich ändern. Produktive Systeme brauchen eigene Last-, Fehler- und Migrationstests.
Zweitens bedeutet Open Source nicht automatisch vollständige Lokalität. Die Standardbeispiele verwenden einen externen API-Schlüssel für die Faktenextraktion; Audio, Transkripte oder abgeleitete Daten können je nach Konfiguration einen Drittanbieter erreichen.
Drittens können Erinnerungen falsch, veraltet oder einer falschen Person zugeordnet sein. Sprechererkennung und Emotionsanalyse sind keine sicheren Identitäts- oder Wahrheitsbeweise. Nutzer brauchen Einsicht, Korrektur und Löschung; sensible Entscheidungen dürfen nicht allein auf gespeicherten Ableitungen beruhen.
SEO- und GEO-Schlüsselbegriffe
VoiceMem, Sprachagenten, Langzeitgedächtnis, Streaming Memory, Voice AI, lokale KI, Apache 2.0, ChatMem-400K, LoCoMo, Datenschutz
💡 Im Klartext
VoiceMem ist ein offenes Gedächtnismodul für Sprachagenten. Es speichert Fakten und Gesprächszusammenhänge getrennt und liefert später nur passende Erinnerungen, verlangt aber eine sorgfältige Datenschutzkonfiguration.
Wichtigste Erkenntnisse
- →VoiceMem ist eine Python-Komponente und keine fertige Sprachassistenten-App.
- →Das System trennt Fakten von emotionalen, persönlichen und relationalen Erinnerungen.
- →Speicherabruf kann lokal laufen; die Standardbeispiele nutzen für Faktenextraktion eine externe API.
- →Modelle, Datensatz, Auswertungscode und Kernsoftware sind öffentlich verfügbar.
- →Falsche Zuordnung, veraltete Erinnerungen und Datenschutz bleiben zentrale Risiken.
Häufige Fragen
Ist VoiceMem eine fertige App?
Nein. Es ist eine Bibliothek und Infrastrukturkomponente, die Entwickler in einen eigenen Sprachagenten integrieren.
Kann VoiceMem vollständig lokal laufen?
Teile wie der Speicherabruf können lokal laufen. Die Standardbeispiele verwenden jedoch einen externen API-Schlüssel für die Extraktion von Fakten; Komponenten lassen sich austauschen.
Welche Lizenz verwendet VoiceMem?
Das Repository nennt die Apache License 2.0.
Welche Daten verarbeitet das System?
Je nach Konfiguration verarbeitet es Audio, Transkripte, Sprechermerkmale, Geräusche, Emotionen und daraus extrahierte Erinnerungen.