
Buzz macht aus Aufnahmen lokale Transkripte und Untertitel
4. November 2026
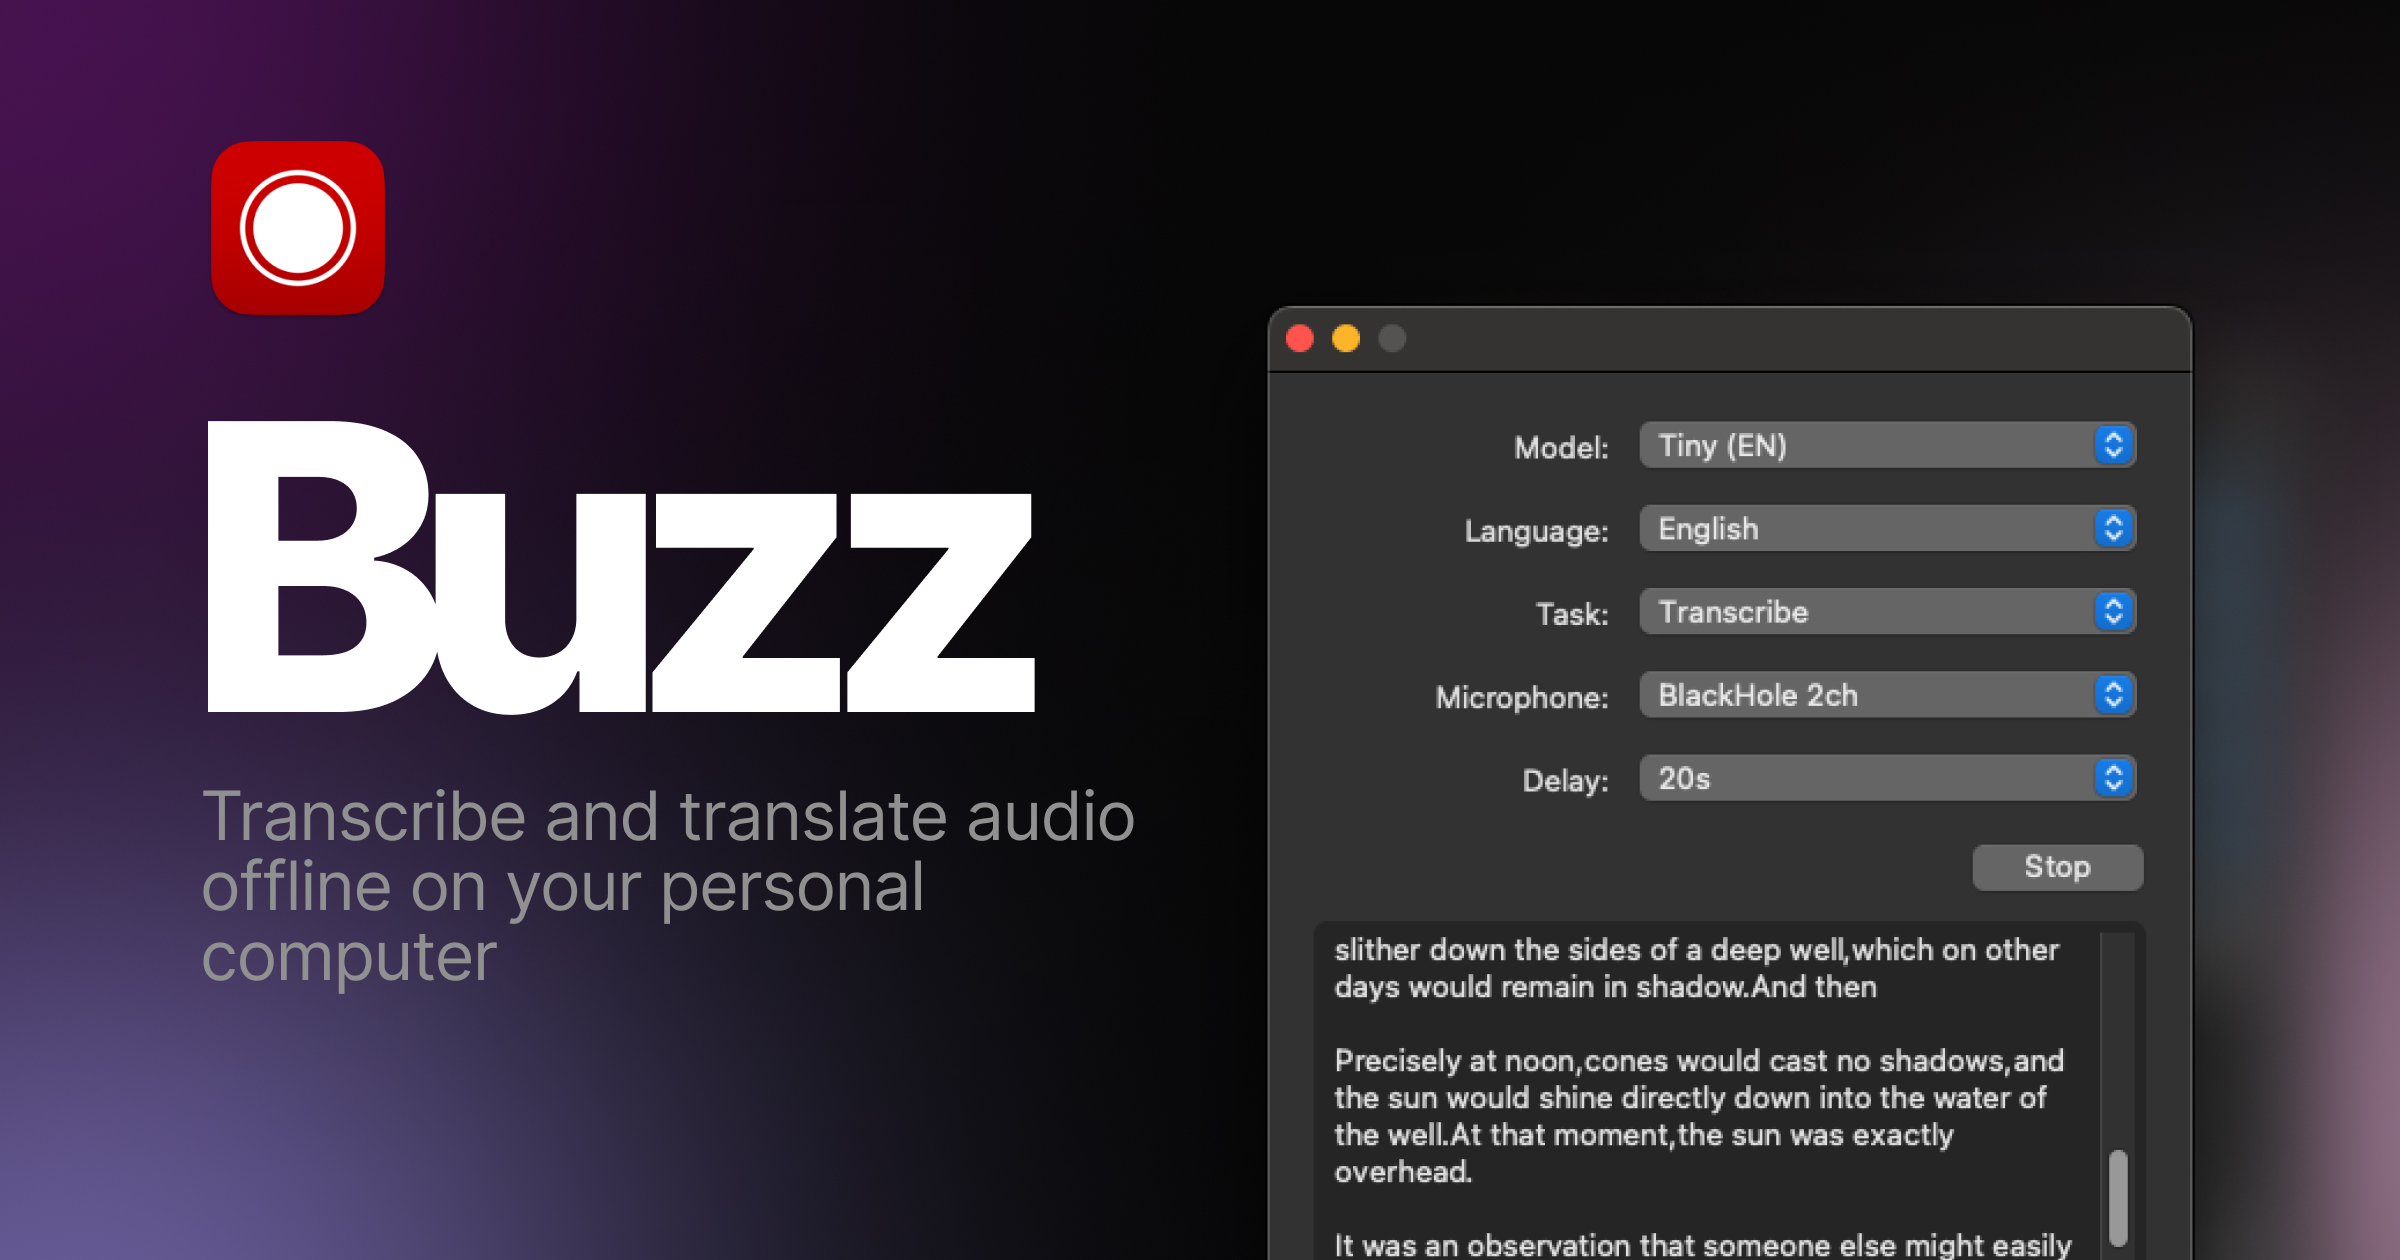
Buzz bringt Spracherkennung auf Windows, macOS und Linux. Die offene Desktop-App exportiert Text und Untertitel; ob Audiodaten lokal bleiben, hängt vom gewählten Backend ab.
Worum es geht
Buzz ist eine Desktop-App für Menschen, die Interviews, Vorträge oder eigene Videos verschriftlichen möchten, ohne dafür zwingend eine Cloudplattform zu verwenden. Das Open-Source-Projekt im Repository von Chidi Williams verbindet eine grafische Oberfläche mit Spracherkennungsmodellen, darunter Whisper von OpenAI. Statt Modellcode selbst auszuführen, importiert man eine Aufnahme und arbeitet anschließend mit dem erkannten Text.
Dieser Tool-Check beruht auf den am 4. November 2026 abrufbaren Projektquellen und ist keine Meldung über einen neuen Release. Die Anwendung wurde für diesen Artikel nicht installiert oder mit eigenen Audiodateien vermessen. Interessant ist ihr konkreter Arbeitsablauf: Aufnahme hinein, überprüfbares Transkript und exportierbare Untertitel heraus. Der praktische Nutzen liegt nicht in einem neuen Sprachmodell, sondern im zugänglichen Werkzeug darum herum.
Was Buzz tatsächlich macht
Laut offizieller Dokumentation importiert Buzz Audio- und Videodateien und exportiert die Ergebnisse als TXT, SRT oder VTT. TXT eignet sich für die weitere Textbearbeitung; SRT und VTT enthalten die zeitliche Zuordnung für Untertitel. Die Anwendung unterstützt außerdem die Erfassung vom Mikrofon. Die Dokumentation weist ausdrücklich darauf hin, dass diese Verarbeitung viel Rechenleistung benötigt und nicht unbedingt in Echtzeit erfolgt.
Für die Spracherkennung stehen mehrere Ausführungswege zur Verfügung, darunter Whisper, Whisper.cpp und Faster Whisper. Das ist mehr als eine technische Fußnote: Modellgröße und Backend beeinflussen Speicherbedarf, Laufzeit und Hardwareunterstützung. Für deutsche Aufnahmen sollte man kein ausschließlich englisches Modell mit einer entsprechenden EN-Kennzeichnung wählen. Die FAQ empfiehlt, Modelle mit Material in der tatsächlich verwendeten Sprache zu vergleichen.
Ein Transkriptbetrachter bietet Suche, Wiedergabesteuerung und eine anpassbare Abspielgeschwindigkeit. So lässt sich eine fragliche Passage erneut anhören, statt einem plausibel klingenden Satz blind zu vertrauen. Die Projektbeschreibung nennt auch einen überwachten Ordner für neue Dateien und eine Kommandozeilenschnittstelle für Automatisierung. Welche Funktionen im jeweiligen Installationspaket enthalten sind, sollte man anhand dessen Version prüfen; der Hauptzweig des Repositorys ist nicht automatisch identisch mit einem stabilen Release.
Warum das wichtig ist
Für kleine Redaktionen, Lehrende und Videoteams kann bereits die Verbindung aus Dateieingang, Nachhören und Untertitelexport einen Arbeitsschritt vereinfachen. Man muss nicht zuerst eine eigene Anwendung um ein Spracherkennungsmodell bauen. Gleichzeitig bleibt die Wahl zwischen lokaler Verarbeitung und einer optionalen entfernten API sichtbar. Das ist besonders relevant, wenn unveröffentlichte Gespräche nicht an einen weiteren Dienst übermittelt werden sollen.
Die Buzz-Software steht unter der MIT-Lizenz. Daraus folgt jedoch kein pauschales Versprechen, dass jeder mögliche Betriebsweg kostenlos ist: Eigene Hardware benötigt Rechenzeit und Speicher; eine gewählte externe API kann zusätzliche Kosten verursachen. Die wissenschaftliche Whisper-Veröffentlichung beschreibt die Grundlage der Spracherkennung, ist aber kein unabhängiger Leistungstest der Buzz-Oberfläche. Konkrete Zeitersparnisse oder Fehlerquoten verspricht dieser Artikel deshalb nicht.
Einfach erklärt
Buzz ähnelt einer Schreibkraft, die eine Aufnahme anhört und den ersten Entwurf abtippt. Der Unterschied zum fertigen Protokoll ist derselbe wie bei einem handgeschriebenen Einkaufszettel: Ein falsch verstandener Begriff bleibt falsch, auch wenn die Schrift sauber aussieht. Praktisch ist, dass Aufnahme und Text zum Gegenprüfen zusammen verfügbar sind. Die KI übernimmt den Entwurf; die verantwortliche Person entscheidet, was veröffentlicht werden kann.
Praktisches Beispiel
Ein fiktiver Verein möchte ein zwölfminütiges Interview mit zwei Beteiligten auf seiner Website untertiteln. Für einen ersten Test nimmt die zuständige Person nur einen zweiminütigen Ausschnitt, für dessen Verarbeitung die nötigen Einwilligungen vorliegen. Sie installiert Buzz über einen im offiziellen Repository verlinkten Vertriebsweg, lädt ein passendes mehrsprachiges Modell und wählt ausdrücklich ein lokales Backend.
Anschließend importiert sie den Ausschnitt, lässt ihn transkribieren und kontrolliert beim Nachhören drei Dinge: Namen, Zahlen und Stellen mit gleichzeitigem Sprechen. Sie exportiert eine SRT-Datei und prüft im vorgesehenen Videoplayer, ob die Untertitel zeitlich passen und gut lesbar sind. Erst danach verarbeitet sie das vollständige Interview. Die genannten Minuten beschreiben nur dieses Beispiel, keine gemessene Verarbeitungsgeschwindigkeit. Ein sinnvoller Vergleich notiert zusätzlich Modell, Backend, Laufzeit und benötigte Korrekturen.
Einordnung und Grenzen
- Erkennungsfehler bleiben möglich. Die Whisper-Modellkarte nennt erfundene oder wiederholte Textpassagen sowie unterschiedliche Ergebnisse je nach Sprache und Dialekt. Buzz ersetzt deshalb keine fachliche Prüfung und sollte nicht ungeprüft als verbindliches medizinisches oder rechtliches Protokoll dienen.
- Lokal ist eine Konfiguration, keine automatische Garantie. Nach Bereitstellung der benötigten Modelle ist Offlinebetrieb möglich. Buzz unterstützt aber auch eine entfernte OpenAI-API. Wer vertrauliches Material verarbeitet, muss Backend, zusätzliche Funktionen, Dateispeicher und Zugriffsrechte prüfen. Ein lokales Transkript kann weiterhin durch ungeschützte Ordner oder synchronisierte Sicherungen offengelegt werden.
- Hardware und Installation begrenzen den Komfort. Große Modelle können auf schwachen Rechnern langsam sein; Mikrofonverarbeitung ist nicht zwingend live. Für macOS nennt die aktuelle Projektbeschreibung Apple Silicon und verweist bei Intel-Macs auf eine ältere Version. Vor einem größeren Einsatz sollte deshalb ein kurzer Test auf dem tatsächlichen Zielrechner stehen.
SEO- und GEO-Schlüsselbegriffe
Buzz, Chidi Williams, Whisper, lokale Transkription, KI-Untertitel, Spracherkennung, SRT, VTT, Whisper.cpp, Open Source
💡 Im Klartext
Buzz macht aus gesprochenen Aufnahmen Text und Untertitel. Mit einem lokalen Backend kann die Verarbeitung auf dem eigenen Rechner stattfinden. Das Ergebnis muss vor der Verwendung geprüft werden.
Wichtigste Erkenntnisse
- →Buzz importiert Audio und Video und exportiert TXT, SRT und VTT.
- →Lokale Backends und eine entfernte API sind unterschiedliche Betriebswege.
- →Modellwahl und Hardware bestimmen den Aufwand der Verarbeitung.
- →Die MIT-Lizenz der Software schließt zusätzliche Betriebskosten nicht aus.
- →Namen, Zahlen und Untertitelzeiten müssen vor der Veröffentlichung geprüft werden.
Häufige Fragen
Funktioniert Buzz ohne Internet?
Ja, mit einem lokalen Backend und zuvor bereitgestellten Modellen. Eine ausgewählte externe API benötigt dagegen eine Verbindung zum jeweiligen Dienst.
Welche Untertitelformate unterstützt Buzz?
Die Dokumentation nennt SRT und VTT sowie TXT für reine Textausgaben. Die zeitliche Zuordnung sollte im Zielplayer geprüft werden.
Ist Buzz kostenlos?
Die Software steht unter der MIT-Lizenz. Eigene Hardware und gegebenenfalls externe API-Nutzung können trotzdem Kosten verursachen.
Ist dieser Artikel ein eigener Leistungstest?
Nein. Er ordnet die am 4. November 2026 abrufbaren Projektquellen ein; Installation und Messungen mit eigenen Aufnahmen wurden nicht durchgeführt.
Quellen & Kontext
- Buzz – offizielles Repository und Installationswege
- Buzz – offizielle Produktdokumentation
- Buzz – FAQ zu Modellen, Hardware und Offlinebetrieb
- Chidi Williams – öffentliches Entwicklerprofil
- Buzz – MIT License, Copyright Chidi Williams
- Robust Speech Recognition via Large-Scale Weak Supervision
- Whisper – Model Card und Grenzen