
FreeToken bringt große MoE-Modelle auf Desktop-Hardware
23. September 2026
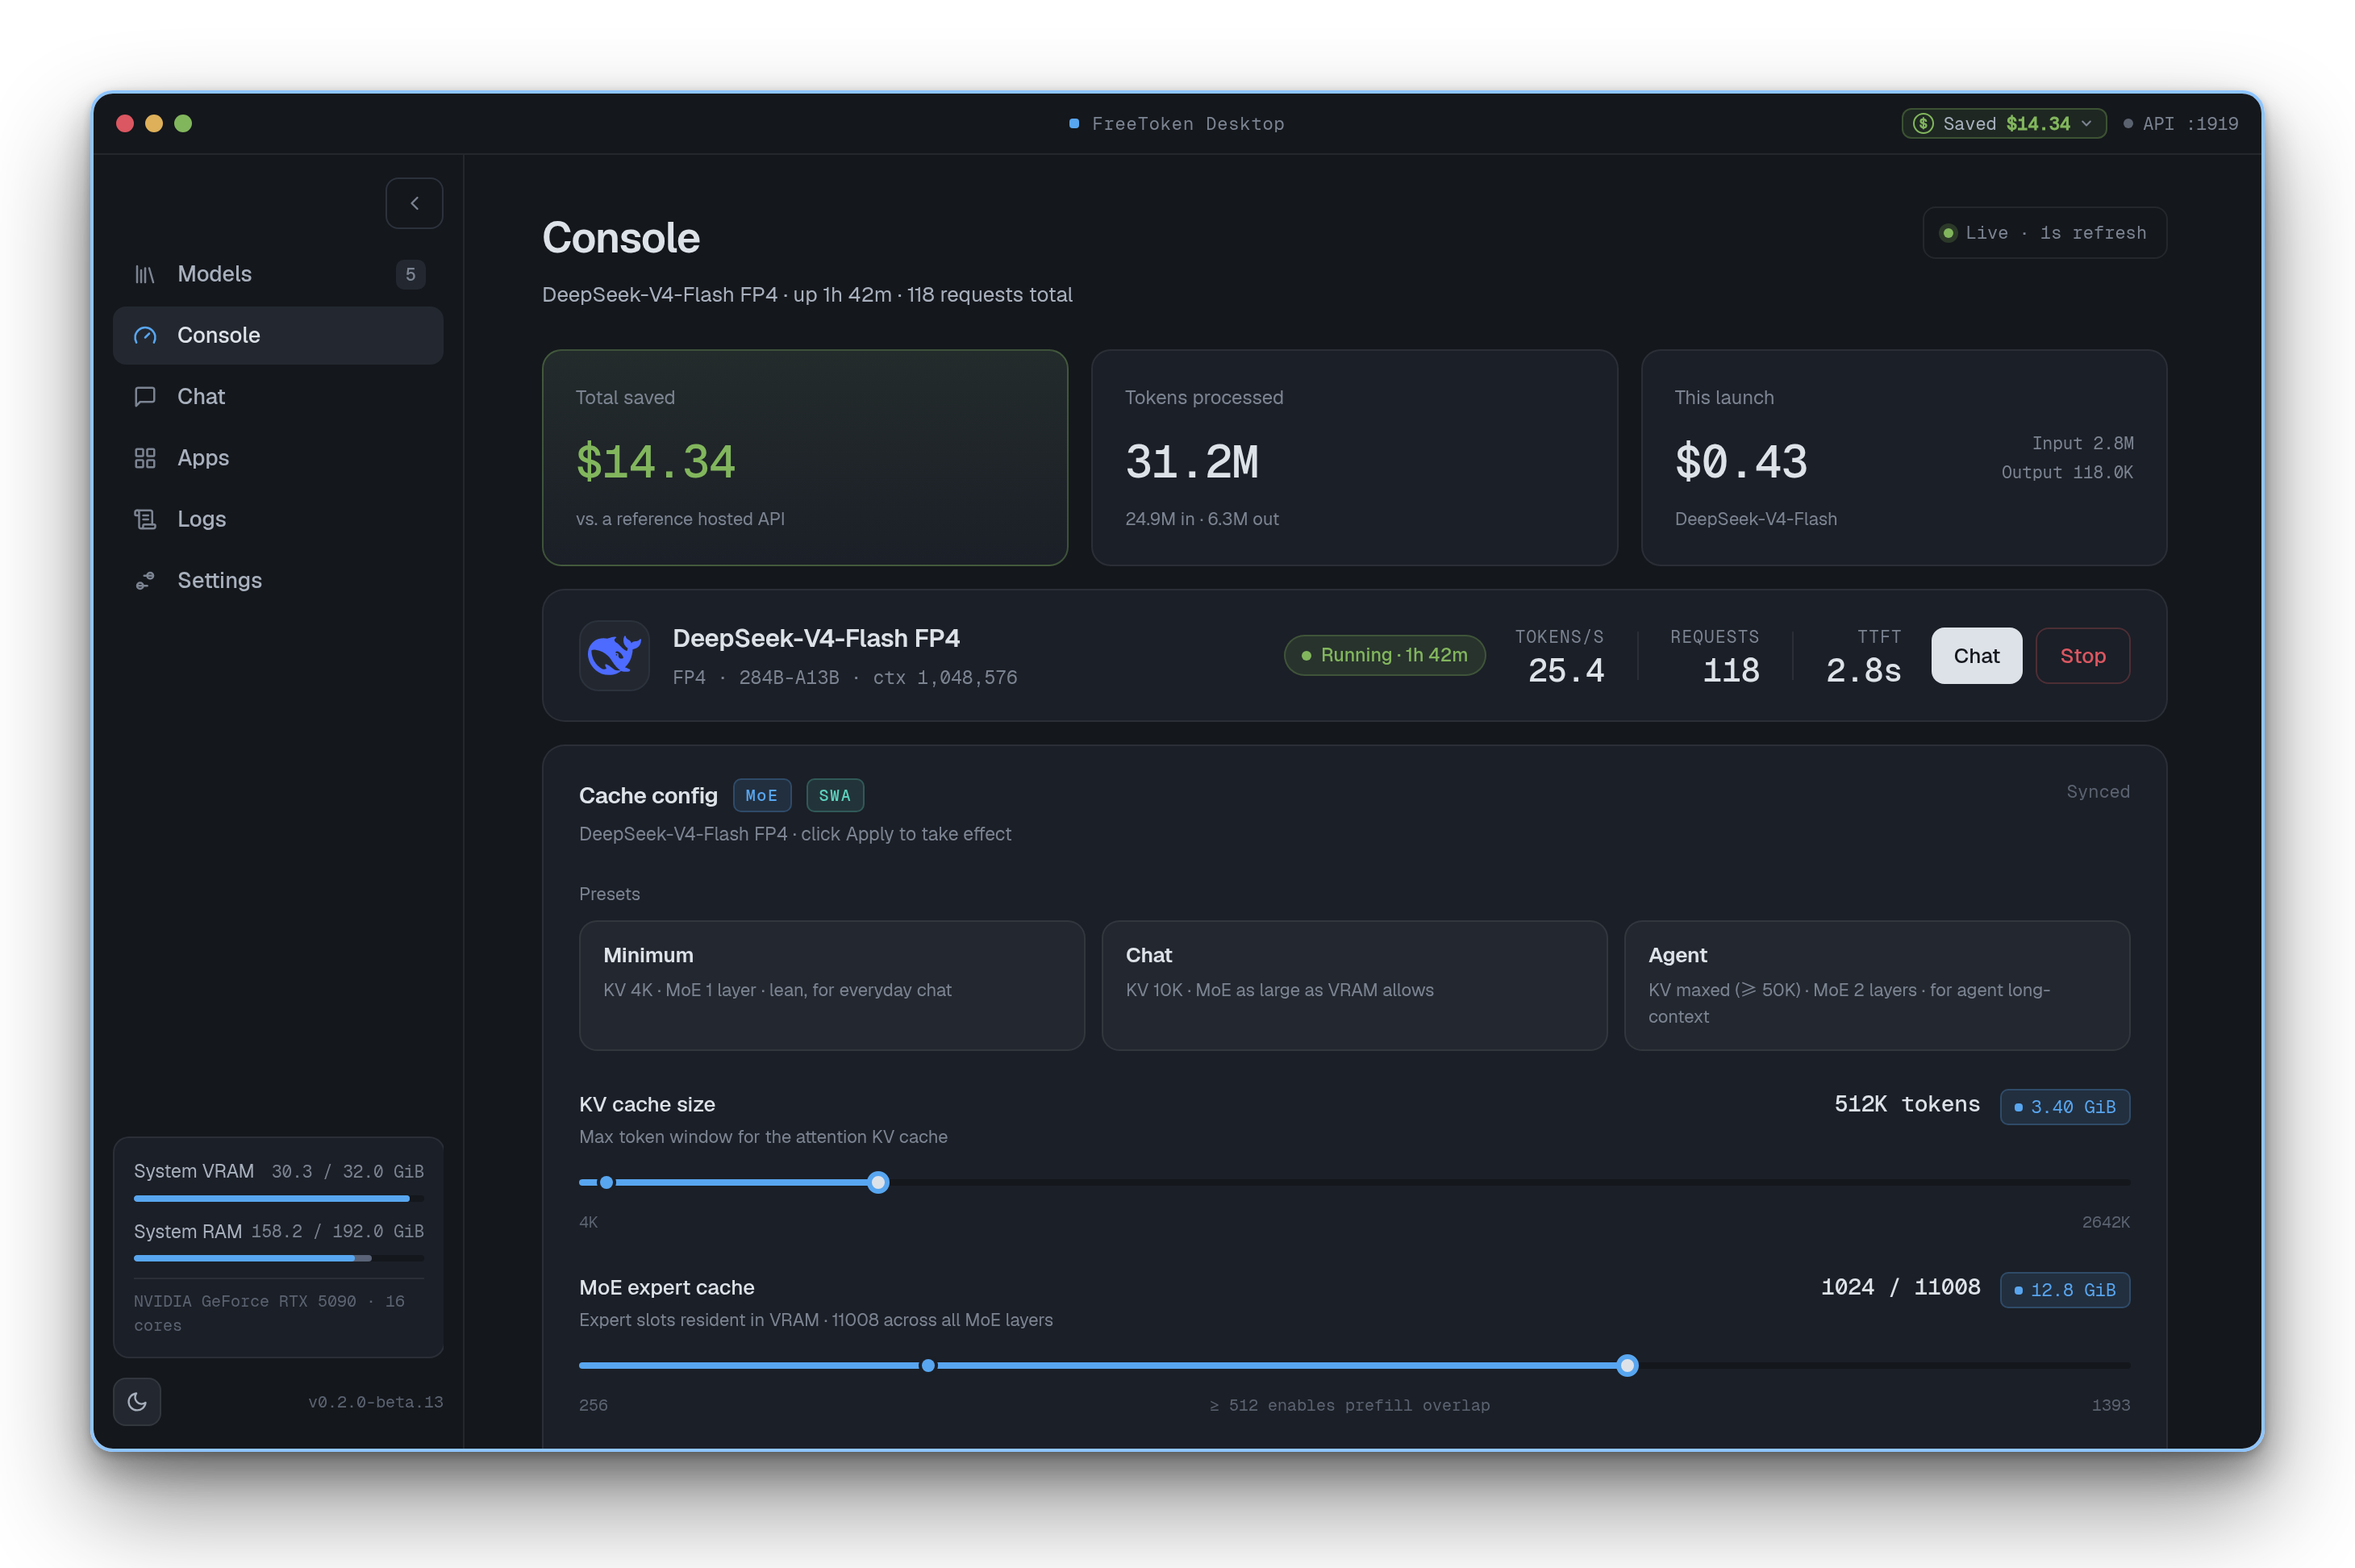
FreeToken verteilt die Ausführung großer Mixture-of-Experts-Modelle auf GPU, CPU und Arbeitsspeicher. Das Open-Source-Werkzeug zielt auf lokale Agenten und verlangt realistische Erwartungen an Tempo und Hardware.
Worum es geht
FreeToken ist eine Open-Source-Laufzeit von FlashML für große Mixture-of-Experts-Modelle, kurz MoE. Das Projekt wurde im Juli 2026 veröffentlicht und soll Modelle, deren vollständige Gewichte nicht in den Grafikspeicher passen, auf Windows- und Linux-Rechnern nutzbar machen. Dafür kombiniert es GPU, CPU und Arbeitsspeicher. Eine Desktop-App bietet Oberfläche, Chat und Einstellungen; zusätzlich gibt es eine Python-basierte Kommandozeile und eine API.
Der Nutzen ist konkret: Teams können offene Modelle lokal testen und über OpenAI- oder Anthropic-kompatible Schnittstellen mit Coding-Agenten verbinden. Das vermeidet nicht automatisch jede Datenübertragung, denn Agenten, Plugins und eingebundene Dienste können weiterhin Netzwerkzugriff haben. Die eigentliche Modellinferenz kann aber auf dem eigenen Rechner bleiben.
Was FreeToken tatsächlich macht
Bei einem MoE-Modell wird pro Verarbeitungsschritt nur ein Teil der spezialisierten Modellblöcke aktiviert. FreeToken hält häufig benötigte Experten in der GPU und lädt andere aus dem Arbeitsspeicher nach. Eine Cache-Strategie, Vorladen und eine laufende Aufteilung des Grafikspeichers zwischen Modellgewichten und Kontext sollen Wartezeiten reduzieren. Das Projekt nennt Unterstützung für NVIDIA-GPUs der RTX-30-, RTX-40- und RTX-50-Reihen.
Die Installation ist entweder über die Desktop-App oder das Python-Paket möglich. Nach Angaben des Projekts lassen sich unterstützte Modelle über eine lokale API an Werkzeuge wie Codex, Claude Code, OpenCode oder OpenClaw anbinden. Die Apache-2.0-Lizenz erlaubt Nutzung, Änderung und Weitergabe unter ihren Bedingungen. Welche Modelle und Quantisierungen tatsächlich funktionieren, steht in einer eigenen, laufend gepflegten Kompatibilitätsliste.
Warum das wichtig ist
Lokale Inferenz scheitert bei großen Modellen oft nicht an der Rechenlogik, sondern an Speicher und Datentransfer. Ein Modell kann zwar quantisiert sein, aber trotzdem mehr Speicher benötigen, als eine einzelne Gaming-GPU besitzt. FreeToken adressiert genau diesen Engpass und behandelt mehrere lokale Speicherarten als gemeinsames System.
Das ist besonders für Entwickler, Forschungsteams und Unternehmen interessant, die sensible Repositories oder Dokumente nicht standardmäßig an einen gehosteten Modellanbieter senden möchten. Zugleich verspricht das Projekt keine Wunder: Die Aussage, Modelle mit mehr als 290 Milliarden Parametern interaktiv auszuführen, stammt vom Anbieter und hängt stark von Modellarchitektur, Quantisierung, RAM, SSD, GPU und Aufgabe ab. Das zugehörige arXiv-Paper beschreibt die technischen Verfahren, ersetzt aber keinen Test auf der eigenen Hardware.
Einfach erklärt
Stell dir eine Werkstatt mit einer kleinen, sehr schnellen Werkbank und einem großen Regal vor. Auf die Werkbank passen nur die Werkzeuge für den aktuellen Arbeitsschritt. FreeToken versucht vorherzusagen, welches Werkzeug als Nächstes gebraucht wird, legt es rechtzeitig bereit und räumt selten genutzte Werkzeuge zurück ins Regal. Das spart Platz, doch jedes Nachladen aus dem Regal kostet Zeit.
Praktisches Beispiel
Ein Entwicklungsteam möchte einen lokalen Coding-Agenten mit einem großen offenen MoE-Modell prüfen. Der Testrechner hat eine NVIDIA-GPU mit 24 GB Grafikspeicher, 128 GB RAM und eine schnelle SSD. Das Team installiert FreeToken, lädt ein ausdrücklich unterstütztes quantisiertes Modell und verbindet den lokalen API-Endpunkt mit seinem Agenten.
Für den ersten Test wählt es 20 typische Aufgaben aus einem nicht produktiven Repository: zehn Fragen zur Architektur, fünf kleine Refactorings und fünf Testergänzungen. Gemessen werden Antwortzeit, RAM- und VRAM-Verbrauch, Qualität der Änderungen und Netzwerkverkehr. Auch Stabilität nach mehreren langen Sitzungen gehört in die Messung. Erst wenn diese Werte zum Arbeitsablauf passen, wird ein begrenzter Pilot mit echtem Code erwogen.
Einordnung und Grenzen
Erstens ist FreeToken jung und hardwareabhängig. Unterstützte NVIDIA-Generationen bedeuten nicht, dass jedes Modell auf jeder Karte sinnvoll schnell läuft. Zweitens verlagert lokale Inferenz Betriebspflichten zum Nutzer: Modell-Downloads, Speicherbedarf, Treiber, Kühlung und Updates bleiben eigene Aufgaben. Drittens schützt ein lokales Modell nicht vor unsicheren Agentenaktionen; Schreibrechte, Shell-Zugriff und externe Integrationen brauchen weiterhin klare Grenzen und Protokollierung.
Außerdem sollten Teams die Leistungsangaben selbst reproduzieren. Der faire Vergleich ist nicht nur Token pro Sekunde, sondern die gesamte Zeit bis zu einem brauchbaren Ergebnis einschließlich Modellstart, Kontextaufbau und Werkzeugaufrufen.
SEO- und GEO-Schlüsselbegriffe
FreeToken, FlashML, lokale KI, Mixture of Experts, MoE Serving, Open-Source-KI, NVIDIA RTX, lokale Coding-Agenten, OpenAI-kompatible API, Anthropic-kompatible API, Datenschutz, Modellinferenz
💡 Im Klartext
FreeToken hilft dabei, sehr große offene KI-Modelle auf einem eigenen Windows- oder Linux-Rechner auszuführen. Es verteilt die Arbeit auf GPU, CPU und RAM; ob das flüssig funktioniert, hängt stark von Modell und Hardware ab.
Wichtigste Erkenntnisse
- →FreeToken ist eine Apache-2.0-lizenzierte Laufzeit für große MoE-Modelle auf lokaler Hardware.
- →Desktop-App, Kommandozeile und kompatible APIs decken unterschiedliche Arbeitsabläufe ab.
- →Das Projekt unterstützt laut eigener Dokumentation NVIDIA-GPUs der RTX-30-, RTX-40- und RTX-50-Reihen.
- →Leistungsangaben sollten mit dem gewünschten Modell und realen Aufgaben überprüft werden.
- →Lokale Inferenz ersetzt keine Rechtebegrenzung für angeschlossene Agenten.
Häufige Fragen
Was ist FreeToken?
FreeToken ist eine lokale Laufzeit für große Mixture-of-Experts-Modelle. Sie nutzt GPU, CPU und Arbeitsspeicher gemeinsam.
Auf welchen Systemen läuft FreeToken?
Das Projekt bietet eine Desktop-App für Windows und Linux sowie eine Python-Installation. Die dokumentierte GPU-Unterstützung konzentriert sich auf NVIDIA RTX 30, 40 und 50.
Bleiben alle Daten garantiert lokal?
Die Modellinferenz kann lokal laufen. Angeschlossene Agenten, APIs oder Integrationen können dennoch Daten übertragen und müssen separat geprüft werden.
Ist FreeToken kostenlos nutzbar?
Der Quellcode steht unter Apache 2.0. Kosten können trotzdem durch Hardware, Strom, Speicher oder zusätzlich genutzte Dienste entstehen.