
PandasAI übersetzt Fragen an Tabellen in ausführbaren Analysecode
15. November 2026
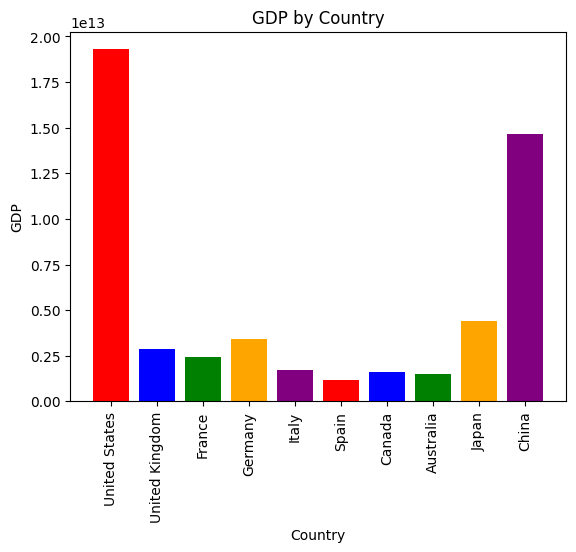
PandasAI verbindet Fragen in Alltagssprache mit Python-Auswertungen und Diagrammen. Die Bibliothek hilft bei Datenanalysen, braucht aber klare Prüfungen für Ergebnisse, Code und Datenschutz.
Worum es geht
Wer regelmäßig Tabellen auswertet, kennt die kleinen Anschlussfragen: Wie verteilt sich der Umsatz auf Regionen? Welche Gruppe liegt vorn? Und wie sieht das als Diagramm aus? PandasAI setzt an dieser Stelle an. Die Python-Bibliothek übersetzt Fragen in Alltagssprache in ausführbaren Analysecode. Sie ist ein konkretes Werkzeug für die Arbeit mit Daten, kein neues Sprachmodell.
Dieser Tool-Check vom 15. November 2026 betrachtet die öffentlich dokumentierte Bibliothek im Repository von Sinaptik-AI. Die Lizenz nennt Sinaptik GmbH als Rechteinhaber. Daneben gibt es ein kommerzielles Angebot auf der Produktwebsite. Beides sollte man auseinanderhalten: Eine selbst eingerichtete Python-Umgebung ist nicht dasselbe wie ein fertig betreuter Dashboard-Dienst. Grundlage dieses Artikels sind die aktuellen Projektquellen; ein eigener Leistungstest wurde nicht durchgeführt.
Was PandasAI tatsächlich macht
Das offizielle Repository zeigt einen nachvollziehbaren Einstieg: Bibliothek installieren, ein Sprachmodell anbinden, eine CSV-Datei laden und eine Frage stellen. Im dokumentierten Beispiel wird dafür eine zusätzliche LiteLLM-Anbindung konfiguriert. Die Frage nach dem durchschnittlichen Umsatz je Region landet anschließend bei einer Chat-Methode des geladenen Datensatzes.
Entscheidend ist, was hinter der sprachlichen Oberfläche passiert. Laut Sicherheitsdokumentation erzeugt das Sprachmodell Python-Code, den PandasAI ausführt. Eine Antwort entsteht also nicht ausschließlich als freier Text: Das Werkzeug kann Berechnungen auf Daten ausführen und Diagramme erzeugen. Das Repository demonstriert außerdem Fragen über mehrere Tabellen hinweg, etwa die Verbindung einer Beschäftigtenliste mit einer Gehaltstabelle.
Damit ist PandasAI besonders für Menschen interessant, die bereits mit Python arbeiten oder Unterstützung bei der Einrichtung erhalten. Die natürlichsprachliche Bedienung nimmt ihnen nicht automatisch die technische Verantwortung ab. Tabellen müssen geladen, Modellzugänge eingerichtet und die Ausführungsumgebung sinnvoll begrenzt werden. Dieser Unterschied ist wichtig, wenn ein Team einen schnellen Prototyp später anderen Nutzern zugänglich machen möchte.
Warum das wichtig ist
Der praktische Nutzen liegt in der kürzeren Strecke zwischen einer fachlichen Frage und einer überprüfbaren Auswertung. Analysten können unterschiedliche Gruppierungen ausprobieren, ohne jedes Mal denselben Einstiegscode neu zu schreiben. Entwickler können eine solche Frageschnittstelle in einen eigenen Datenablauf einbauen. Für eine einmalige, einfache Summe bleibt eine Tabellenkalkulation häufig die übersichtlichere Lösung.
Ein vom Anbieter unabhängiger Überblick des USDSI ordnet PandasAI ebenfalls als Werkzeug für Datenexploration, Visualisierung und Analyse im Python-Umfeld ein. Das ist eine zusätzliche Einordnung, kein unabhängiger Genauigkeitsnachweis. Konkrete Zeitersparnisse lassen sich daraus für das eigene Team nicht ableiten.
Unser redaktioneller Nutzwert-Score beträgt 8 von 10: Der Anwendungsfall ist klar, der Einstieg im Repository konkret und die Trennung zwischen Analysecode und Modellanbindung praktisch relevant. Abzüge gibt es für den Einrichtungsaufwand und die notwendige Kontrolle. Der Score bewertet die belegte Nützlichkeit des Ansatzes, nicht eine gemessene Fehlerquote.
Einfach erklärt
Man kann sich PandasAI wie eine Person vorstellen, der man beim Sortieren von Einkaufsbelegen zuruft: „Lege alle Lebensmittel zusammen und rechne ihre Beträge aus.“ Die Person übersetzt die Bitte in einzelne Arbeitsschritte. Das spart das Ausformulieren jedes Handgriffs. Sie kann aber einen Restaurantbeleg falsch zuordnen oder eine Rückerstattung übersehen. Deshalb bleiben klare Begriffe und ein Blick auf die sortierten Belege wichtig.
Praktisches Beispiel
Ein fiktives Handelsunternehmen testet das Werkzeug mit einer künstlichen CSV-Datei: 120 Bestellungen, drei Regionen und die Spalten Datum, Region, Nettoumsatz und Stornierung. Das Team kennt die korrekten Summen bereits aus einer manuell kontrollierten Referenztabelle. Es fragt zunächst nach dem Nettoumsatz je Region, ausdrücklich ohne stornierte Bestellungen.
Danach lässt es die Werte als Balkendiagramm darstellen und fragt nach der Region mit dem höchsten Umsatz. Der entscheidende Test ist nicht, ob die Grafik professionell aussieht. Stimmen die Summen mit der Referenz überein? Wurden Stornierungen wirklich ausgeschlossen? Verändert eine leicht anders formulierte Frage die Berechnung?
Für einen zweiten Durchlauf ergänzt das Team einen fehlenden Umsatzwert und einen doppelt vorhandenen Datensatz. Es prüft, ob das Werkzeug diese Fälle sinnvoll behandelt oder stillschweigend andere Annahmen trifft. Erst wenn Ergebnisse und Vorgehen nachvollziehbar sind, lohnt sich ein größerer Versuch. Das hier beschriebene Szenario ist ein Testvorschlag, kein Bericht über einen durchgeführten Kundenversuch.
Einordnung und Grenzen
- Richtige Berechnung braucht richtige Bedeutung. Ein plausibles Ergebnis kann auf falschen Filtern, unpassenden Tabellenverknüpfungen oder einem missverstandenen Umsatzbegriff beruhen. Die Antwort ersetzt weder Datenbereinigung noch fachliche Prüfung. Für verbindliche Berichte braucht es nachvollziehbare Referenzen.
- Erzeugter Code ist eine Sicherheitsgrenze. Die Dokumentation empfiehlt eine Docker-Sandbox insbesondere für öffentliche Anwendungen, nicht vertrauenswürdige Eingaben und sensible Daten. Sie beschreibt isolierte, netzwerklose Codeausführung und Ressourcenbegrenzungen. Diese Sandbox muss bewusst eingerichtet werden; die Sprachschnittstelle allein bietet keine ausreichende Absicherung. Auch eine Sandbox ist kein pauschaler Sicherheitsnachweis.
- Lokal installiert bedeutet nicht automatisch vollständig lokal. Die dokumentierte Modellanbindung verwendet einen externen API-Zugang. Welche Informationen die jeweilige Konfiguration an den Modellanbieter übermittelt, muss vor vertraulichen Analysen geprüft werden. Die netzwerklose Code-Sandbox ist nicht mit einem vollständig offline arbeitenden Gesamtsystem gleichzusetzen. Hinzu kommen mögliche Modell- und Infrastrukturkosten. Der Kern steht laut Lizenz unter MIT Expat, Enterprise-Bereiche haben gesonderte Bedingungen; für kommerzielle Angebote nennt das Repository einen Kontaktweg statt eines belastbaren Pauschalpreises.
Das Hero-Bild zeigt ein Diagramm aus dem offiziellen Repository, keine Messung dieses Checks und keine von uns verifizierte Wirtschaftsstatistik. Bildquelle: Sinaptik GmbH/PandasAI; Lizenz siehe Quellen. Der nächste sinnvolle Schritt bleibt ein kleiner, künstlicher Datensatz mit bekannten Antworten, nicht die sofortige Anbindung vertraulicher Geschäftsdaten.
SEO- und GEO-Schlüsselbegriffe
PandasAI, Sinaptik GmbH, Python, Datenanalyse, CSV, natürliche Sprache, Datenvisualisierung, Docker-Sandbox, Modellanbindung, Datenschutz
💡 Im Klartext
PandasAI macht aus Fragen an Tabellen Python-Auswertungen und Diagramme. Dafür braucht es ein angebundenes Sprachmodell und eine eingerichtete Umgebung. Ergebnisse und erzeugter Code müssen kontrolliert werden.
Wichtigste Erkenntnisse
- →PandasAI ist eine nutzbare Python-Bibliothek für Fragen an Daten und Diagramme.
- →Das Repository zeigt CSV-Auswertungen und Fragen über mehrere Tabellen hinweg.
- →Die Ausführung erzeugten Codes erfordert eine bewusst abgesicherte Umgebung.
- →Ein lokales Setup garantiert keine vollständig lokale Modellverarbeitung.
- →Der MIT-Expat-Kern und gesondert lizenzierte Enterprise-Bereiche müssen unterschieden werden.
Häufige Fragen
Brauche ich Python-Kenntnisse?
Für die Einrichtung der hier betrachteten Bibliothek sind Python-Kenntnisse oder technische Unterstützung sinnvoll. Fragen lassen sich anschließend in Alltagssprache formulieren.
Ist PandasAI kostenlos?
Der Kern steht unter MIT Expat, Enterprise-Bereiche haben andere Bedingungen. Modellzugriffe, Infrastruktur oder betreute Angebote können zusätzlich kosten.
Bleiben meine Daten auf meinem Rechner?
Das hängt von der Modellanbindung und Konfiguration ab. Eine offline arbeitende Code-Sandbox bedeutet nicht, dass auch die Modellanfragen lokal bleiben.
Wie teste ich die Zuverlässigkeit?
Beginne mit künstlichen Daten und bekannten Ergebnissen. Prüfe zusätzlich fehlende Werte, doppelte Zeilen und unterschiedlich formulierte Fragen.