
Unstract macht aus Dokumenten strukturierte Daten für eigene Abläufe
10. November 2026
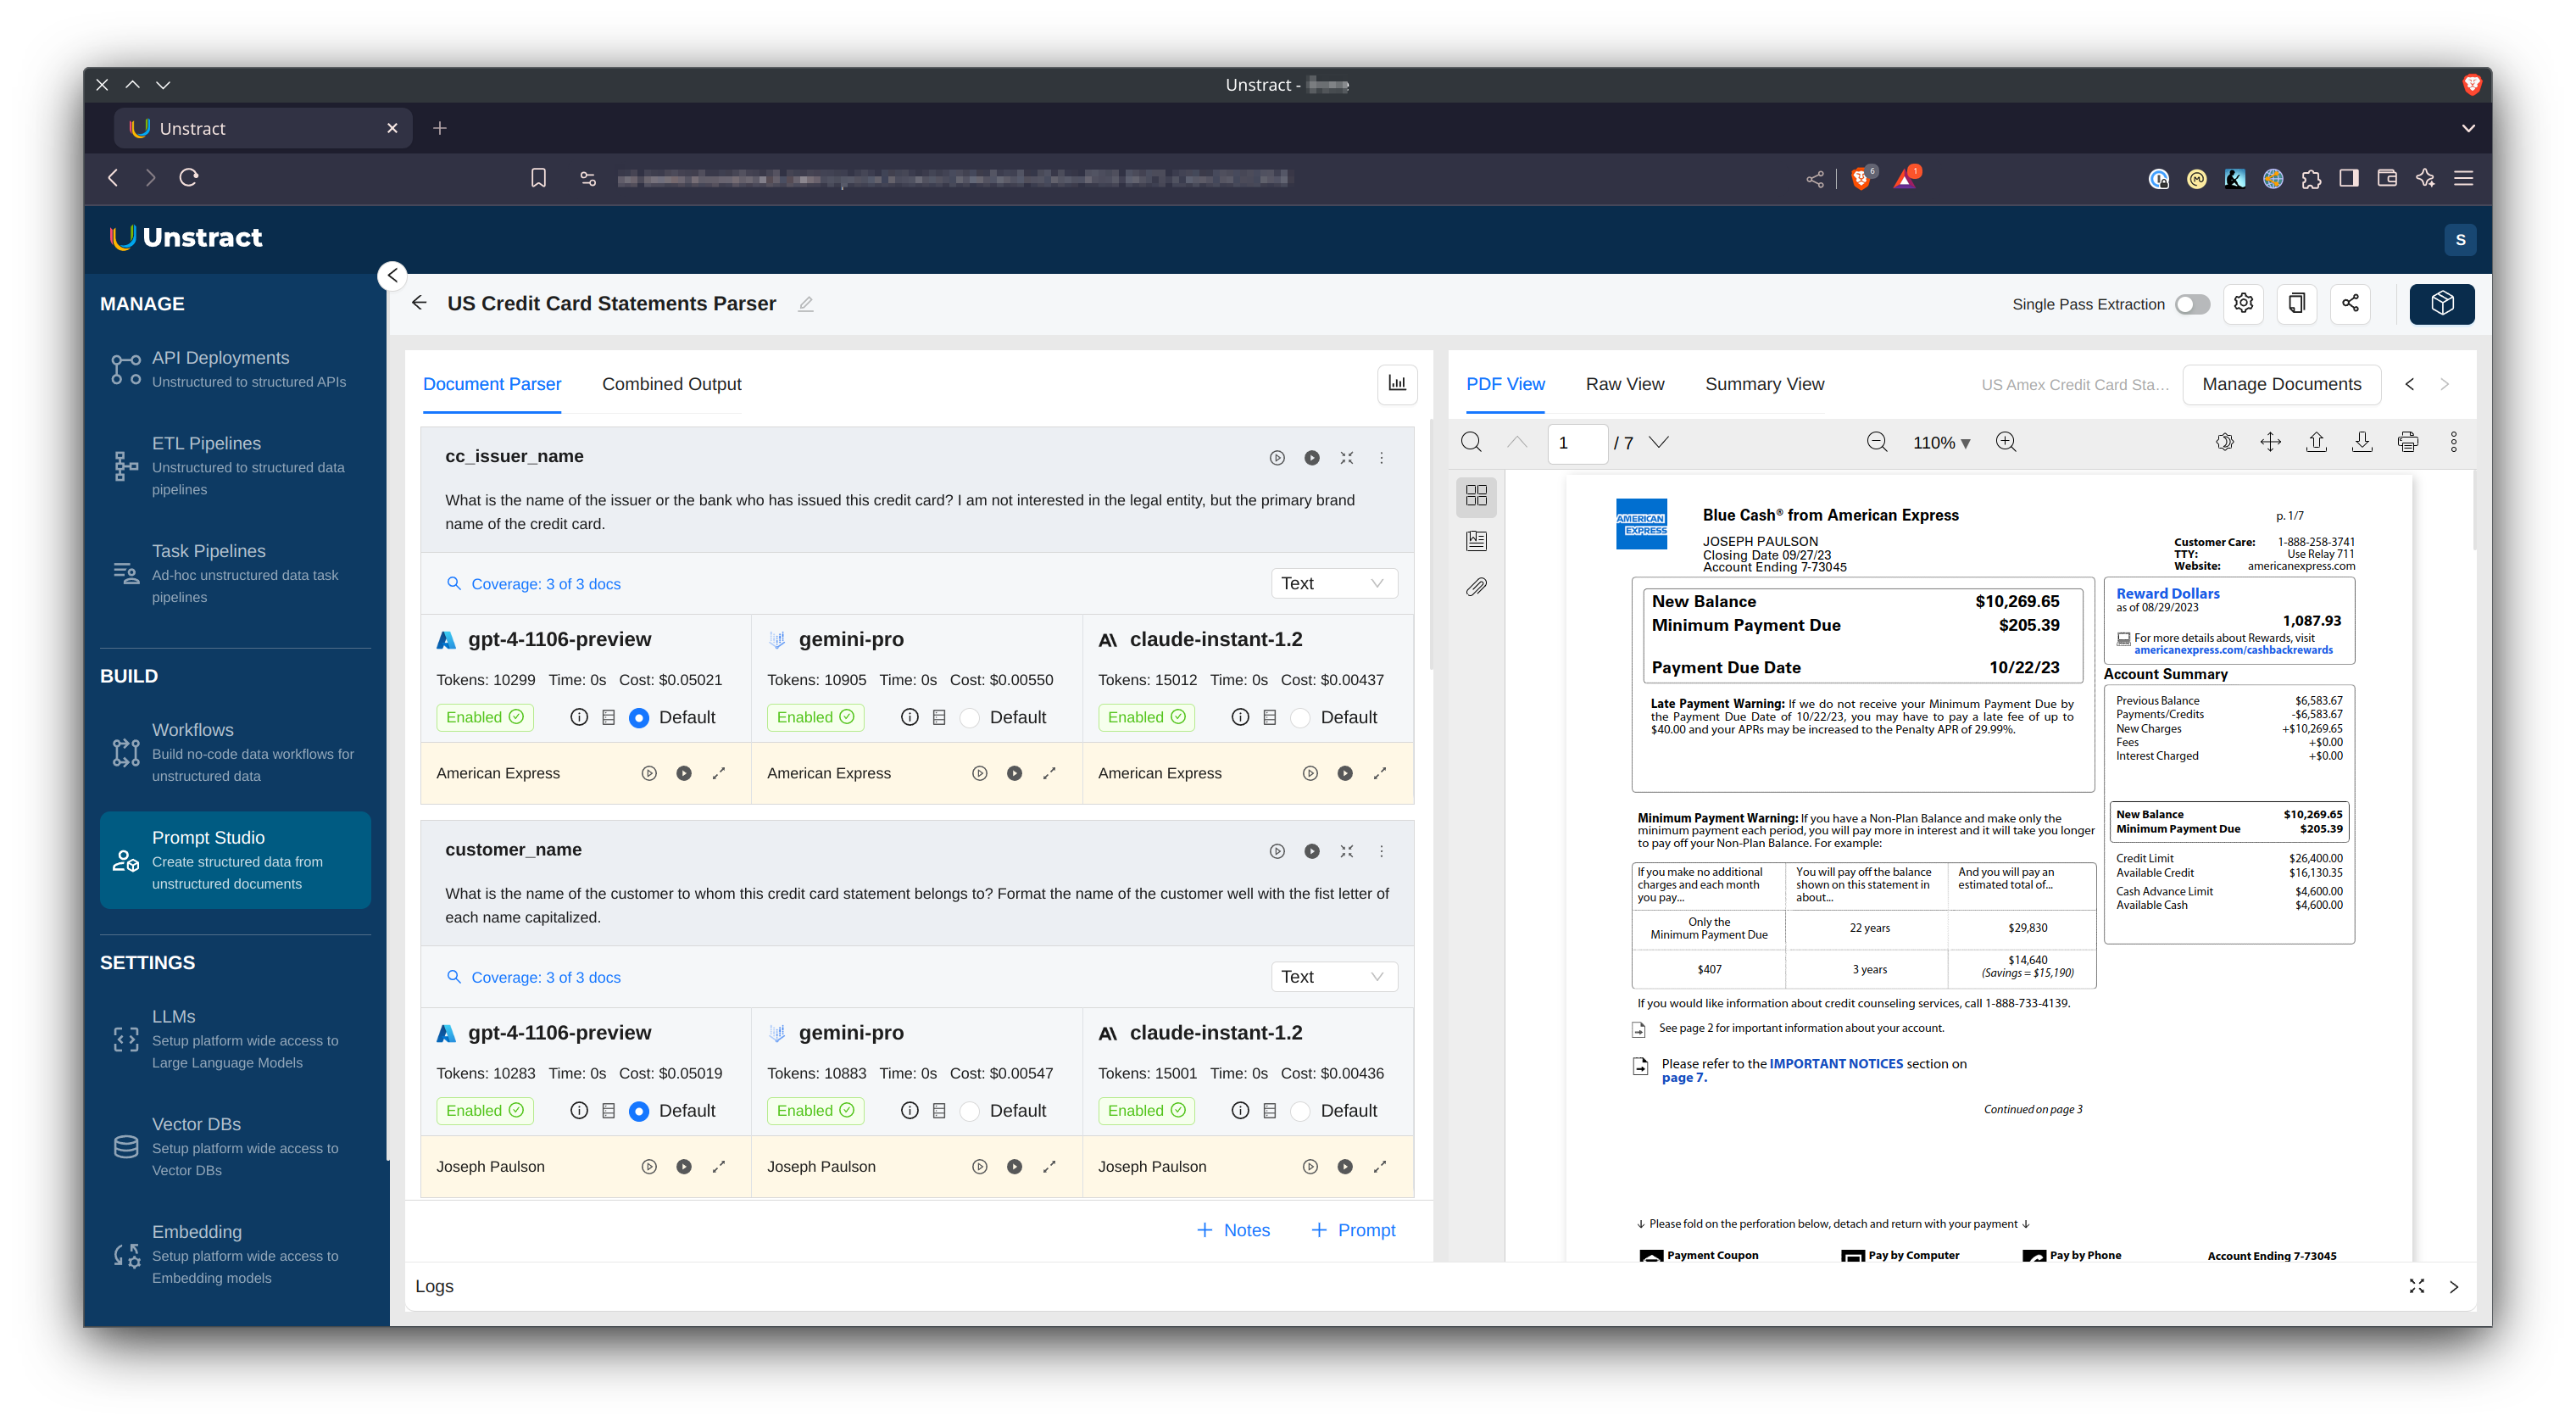
Unstract verbindet KI-Extraktion mit einer Oberfläche für Prompts, APIs und Datenpipelines. Der Tool-Check erklärt den Nutzen, die Grenzen der offenen Ausgabe und wichtige Datenschutzfragen.
Worum es geht
Wer Rechnungen oder Abrechnungen aus unterschiedlichen Quellen verarbeitet, kennt das Problem: Die gesuchten Angaben sind ähnlich, stehen aber jedes Mal woanders. Unstract von Zipstack soll aus solchen Dokumenten einheitlich strukturierte Daten machen. Statt einem Chatbot immer wieder dieselben Fragen zu stellen, legt ein Team fest, welche Felder es benötigt, und baut daraus einen wiederverwendbaren Ablauf.
Dieser Tool-Check basiert auf den am 10. November 2026 abgerufenen Produktseiten, dem öffentlichen Repository und der Dokumentation. Es geht nicht um einen behaupteten Tageslaunch, sondern um ein bereits nutzbares Werkzeug. Unstract bietet eine Open-Source-Ausgabe sowie kommerzielle Cloud- und On-Premise-Angebote. Ein eigener Leistungstest mit vertraulichen Dokumenten wurde für diesen Artikel nicht durchgeführt.
Was Unstract tatsächlich macht
Im Prompt Studio beschreiben Nutzer in normaler Sprache, welche Informationen aus einem Dokument gebraucht werden. Bei einer Rechnung könnten das Lieferant, Rechnungsnummer, Datum und Gesamtbetrag sein. Ein Textextraktor bereitet den Inhalt auf; ein angebundenes Sprachmodell übernimmt die eigentliche strukturierte Auswertung. Das Ergebnis lässt sich als JSON weiterverarbeiten, also als Datensatz mit eindeutig benannten Feldern.
Die offizielle Kurzanleitung demonstriert diesen Weg anhand unterschiedlich aufgebauter Kreditkartenabrechnungen. Aus dem Projekt kann eine API entstehen: Eine andere Anwendung übergibt ein Dokument und erhält strukturierte Daten zurück. Alternativ verarbeitet eine ETL-Pipeline Dateien aus einer Quelle und lädt die Ergebnisse in eine Datenbank. ETL bezeichnet hier das Auslesen, Umformen und Weiterreichen von Daten.
Das Repository nennt außerdem einen MCP-Server für KI-Agenten und einen n8n-Knoten für bestehende Automatisierungen. Es führt unter anderem Ollama als lokale Modellanbindung sowie verschiedene Cloud-Anbieter auf. Das bedeutet Auswahl bei den Bausteinen, aber keine Garantie, dass jede Kombination dieselben Ergebnisse liefert. Modell, Textextraktor und Speicher müssen zum gewünschten Einsatz passen.
Warum das wichtig ist
Interessant ist Unstract vor allem für technische Teams, die einen wiederkehrenden Dokumenteneingang in bestehende Software integrieren möchten. Der praktische Unterschied zu einem einzelnen Chat liegt im wiederverwendbaren Schema und in den Schnittstellen: Nicht nur eine Person liest eine Antwort, sondern eine nachgelagerte Anwendung kann definierte Felder übernehmen.
Für gelegentliche Einzeldokumente dürfte die Einrichtung häufig zu aufwendig sein. Das offene Repository beschreibt mehrere Dienste und nennt Linux oder macOS, Docker, Docker Compose und mindestens 8 GB Arbeitsspeicher als Voraussetzungen. Wer ein lokales Sprachmodell betreibt, muss dessen Ressourcen zusätzlich berücksichtigen. Eine Browseroberfläche macht den Betrieb also nicht automatisch wartungsfrei.
Auch auf Hacker News wurde das Projekt vorgestellt und verlinkt. Diese unabhängige Community-Fundstelle belegt öffentliche Aufmerksamkeit, ist aber kein belastbarer Genauigkeitstest. Deshalb übernehmen wir keine pauschalen Leistungsversprechen des Anbieters. Entscheidend bleibt, wie gut die eigenen Dokumenttypen verarbeitet werden.
Einfach erklärt
Stell dir eine Poststelle vor, die jeden Tag unterschiedlich gestaltete Formulare erhält. Statt die Formulare nach ihrem Aussehen zu sortieren, bekommt eine Mitarbeiterin einen leeren Erfassungsbogen: Name hier, Datum dort, Betrag in die letzte Spalte. Unstract organisiert einen ähnlichen Arbeitsgang mit Texterkennung, Sprachmodell und festgelegten Ausgabefeldern.
Der Erfassungsbogen sorgt für Ordnung, beweist aber nicht, dass jede Zahl richtig abgeschrieben wurde. Ein ordentlich ausgefülltes Feld kann trotzdem den falschen Betrag enthalten. Genau deshalb gehören Stichproben und klare Regeln für fehlende Angaben zum Ablauf.
Praktisches Beispiel
Ein fiktives kleines Beschaffungsteam möchte 20 künstlich erstellte Rechnungen aus vier unterschiedlichen Layouts prüfen. Es definiert fünf Felder: Lieferant, Rechnungsnummer, Rechnungsdatum, Währung und Gesamtbetrag. Damit entstehen 100 einzeln kontrollierbare Feldwerte. Diese Zahlen beschreiben einen vorgeschlagenen Test, keine gemessene Produktleistung.
Zunächst legt das Team die korrekten Werte von Hand fest. Dann richtet es ein Prompt-Studio-Projekt ein und vergleicht die Ausgabe mit dieser Referenz. Einige Testbelege enthalten absichtlich eine fehlende Rechnungsnummer, einen schwer lesbaren Betrag oder mehrere Währungen. Das Team prüft nicht nur Treffer, sondern auch, ob fehlende Angaben als fehlend erkennbar bleiben.
Erst danach bindet es die API an eine Testdatenbank an. Es misst Laufzeit, Modellkosten und den Aufwand für Korrekturen. Eine Buchung oder Zahlung wird dabei ausdrücklich nicht ausgelöst. Der nächste sinnvolle Schritt ist somit ein begrenzter, nachprüfbarer Extraktionstest, nicht die sofortige Automatisierung der gesamten Buchhaltung.
Einordnung und Grenzen
- Ausgabestruktur ist keine Richtigkeitsgarantie. Schlecht lesbare Scans, mehrdeutige Tabellen und ähnlich bezeichnete Summen können zu falschen oder unvollständigen Werten führen. Kritische Beträge brauchen einen Abgleich mit dem Original. Die integrierte menschliche Qualitätsprüfung mit Quellenmarkierung gehört laut Dokumentation nicht zur offenen Ausgabe; dort muss ein geeigneter Prüfprozess anders organisiert werden.
- Selbsthosting ist nicht gleich vollständige Datenhoheit. Externe Modelle oder Textextraktoren können Dokumentinhalte außerhalb des eigenen Systems verarbeiten. LLMWhisperer ist nicht quelloffen und muss bei Bedarf separat als Cloud- oder On-Premise-Angebot genutzt werden. Das Repository nennt außerdem abschaltbare Nutzungsanalyse. Besonders wichtig: Die veröffentlichten Nutzungsbedingungen enthalten in Abschnitt 3.1 weitreichende Rechte an Daten aus Demo-, Test- und Gratisnutzung. Für erste Versuche sind deshalb künstliche Dokumente sinnvoll; echte Daten benötigen eine vorherige Prüfung der konkreten Verträge und Datenwege.
- Kosten und Editionen unterscheiden sich deutlich. Das Repository nennt AGPL-3.0 als Lizenz. Die offene Software beseitigt jedoch weder Infrastruktur- noch mögliche Modell- und Extraktionskosten. Die Editionsübersicht nennt am Recherchetag einen Cloud-Einstieg ab 499 US-Dollar monatlich; der tatsächliche Leistungsumfang ist vor Bestellung zu prüfen. Funktionen wie LLMChallenge, SinglePass, SummarizedExtraction und Human Quality Review sind nicht in der offenen Ausgabe enthalten. Wer diese benötigt, sollte nicht mit einer funktionsgleichen Gratisversion kalkulieren.
Das Hero-Bild ist ein offizieller Repository-Screenshot des Prompt Studios mit Beispielabrechnung. Die dort sichtbaren Modellnamen und Kostenanzeigen sind Teil dieser Abbildung, keine aktuellen Empfehlungen oder Preisangaben dieses Artikels.
SEO- und GEO-Schlüsselbegriffe
Unstract, Zipstack, Dokumentenextraktion, Prompt Studio, strukturierte Daten, JSON, ETL, Document AI, Selbsthosting, AGPL-3.0
💡 Im Klartext
Unstract liest gewünschte Angaben aus Dokumenten und gibt sie in einem einheitlichen Datenformat zurück. Das hilft beim Anschluss an andere Programme. Ob die Angaben stimmen und wohin Daten fließen, muss das Team weiterhin prüfen.
Wichtigste Erkenntnisse
- →Prompt Studio verbindet natürlichsprachliche Extraktionsvorgaben mit strukturierten JSON-Ausgaben.
- →APIs und ETL-Pipelines machen die Ergebnisse für andere Anwendungen nutzbar.
- →Die offene Ausgabe steht laut Repository unter AGPL-3.0 und enthält nicht alle kommerziellen Prüffunktionen.
- →Selbsthosting verhindert keine Datenübertragung an extern angebundene Modelle oder Textextraktoren.
- →Ein Test mit künstlichen Dokumenten und bekannten Referenzwerten ist der sinnvolle Einstieg.
Häufige Fragen
Ist Unstract kostenlos?
Es gibt eine Open-Source-Ausgabe unter AGPL-3.0. Infrastruktur, externe Modelle und Textextraktion können dennoch Kosten verursachen; kommerzielle Editionen haben einen anderen Funktionsumfang.
Bleiben Dokumente beim Selbsthosting automatisch lokal?
Nein. Die Datenwege hängen auch von den angebundenen Modellen, Textextraktoren und Speichern ab und müssen einzeln geprüft werden.
Welche Funktionen fehlen in der offenen Ausgabe?
Laut Dokumentation fehlen unter anderem LLMChallenge, SinglePass, SummarizedExtraction und Human Quality Review. Die Editionsübersicht sollte vor der Entscheidung geprüft werden.
Wie lässt sich der Nutzen ohne vertrauliche Daten testen?
Mit künstlichen Dokumenten, festgelegten Zielfeldern und manuell geprüften Referenzwerten. Erst wenn Fehler und Kosten verstanden sind, sollte eine Anbindung an echte Abläufe folgen.
Quellen & Kontext
- Unstract: offizielle Produktseite
- Zipstack/unstract: Repository, Funktionen und Lizenzhinweis
- Unstract Documentation: Getting Started
- Unstract Documentation: Open Source Edition
- Unstract: Editionsvergleich und Preisangaben
- Zipstack, Inc.: Terms of Service und Anbieteridentität
- Unstract: Privacy Policy
- Hacker News: unabhängiger Community-Verweis, kein Leistungstest
- Unstract: offizieller Prompt-Studio-Screenshot